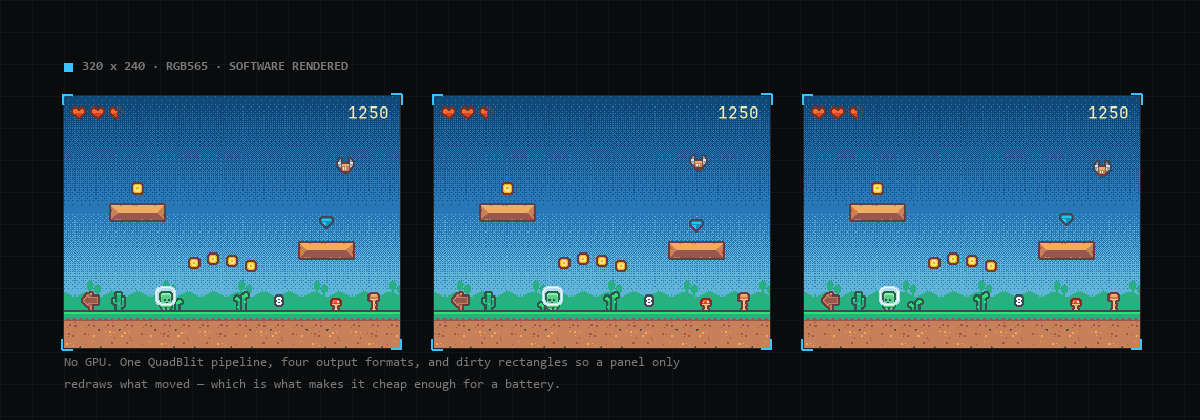
Deki はすべてをソフトウェアで描画します。GPU はなく、CPU がフレームバッファを埋め、バスがそれをパネルへ運ぶだけです。PSRAM 付きの ESP32-S3 と 320×240 の SPI ディスプレイで、デモは最初、毎秒 16 フレームで動いていました。画面に出ているものに、そこまで遅くなる理由はありません。背景、いくつかのスプライト、テキスト、少しのパーティクルだけです。今ではどのシーンも 60 から 63 で動きます。ここでは、何が邪魔をしていたのかを書きます。
デバイスで計測する
デスクトップでのプロファイルは、マイコンについてほとんど何も教えてくれません。そこで最初に、ボード自身に尋ねる方法を作りました。ファームウェアは今、USB シリアル越しにいくつかのリクエストに応えます。平均的なフレームの更新・描画・送信時間とあわせた毎秒のフレーム数、コンポーネントの種類ごとの描画時間、そして「このシーンを開いて」です。これでスクリプトがすべてのシーンを順に開いて計測できます(エディターも同じリクエストを使っています。ボードから取るスクリーンショットと統計を見てください)。以下の数字はすべてそこから取ったものです。
コンパイラーはデバッガー向けにビルドしていた
ESP-IDF はデフォルトで -Og、つまりデバッグ向けの最適化でビルドします。ピクセル単位の C++ は、まさにそれでいちばん遅くなる種類のコードです。Deki のデバイス向けビルドは、今は -O2 を使います。
ピクセルごとの関数呼び出し
ピクセルは memcpy(&v, p, 2) で読んでいました。アラインされていないかもしれない 2 バイトを読む、移植性のある書き方です。x86 なら 1 命令です。ところが S3 の Xtensa コアにはアラインされていないロードがないので、GCC はこれを memcpy の呼び出しにしていました。すべてのスプライトのすべてのピクセルごとに 1 回です。2 バイトを個別に読んでシフトで組み合わせるようにしたら、ブリットが 6 倍速くなりました。
計算なしで色を付ける
色付け(ティント)したスプライト、たとえば色を付けた UI パネルは、汎用のパイプラインを通っていました。ピクセルごとに、展開、各チャンネルの乗算、除算、ブレンド、パックです。ですが RGB565 の画像には、赤が 32 段階、緑が 64 段階、青が 32 段階しかありません。そこで色付けは描画ごとに一度だけルックアップテーブルとして計算するようにし、不透明なピクセルは 3 回のルックアップで済むようになりました。すべてのピクセルが以前と同じ結果になることを、テストで確認しています。
さらに良いのは、そもそも色付けしないことです。9-slice パネルはすでに引き伸ばした状態でキャッシュ画像にしているので、色もその画像に焼き込み、色が変わったときだけやり直すようにしました。ほとんどがパネルでできた画面は、55 fps から約 62 fps になりました。
フレームの送信に 31 ms
320×240 のフレームは 150 KB です。ディスプレイが最初に使っていた 40 MHz の SPI クロックでは、送るのに 31 ms かかっていました。60 fps でほぼ 2 フレーム分です。パネルは 80 MHz で動くので、それで半分になりました。
それでもまだ、描画と送信は順番に行われていて、S3 の 2 つ目のコアは何もしていませんでした。今は、描き終わったフレームを PSRAM 上の 2 つのバッファの片方に入れ、次のフレームを描いている間に、もう一方のコアがそれを送ります。
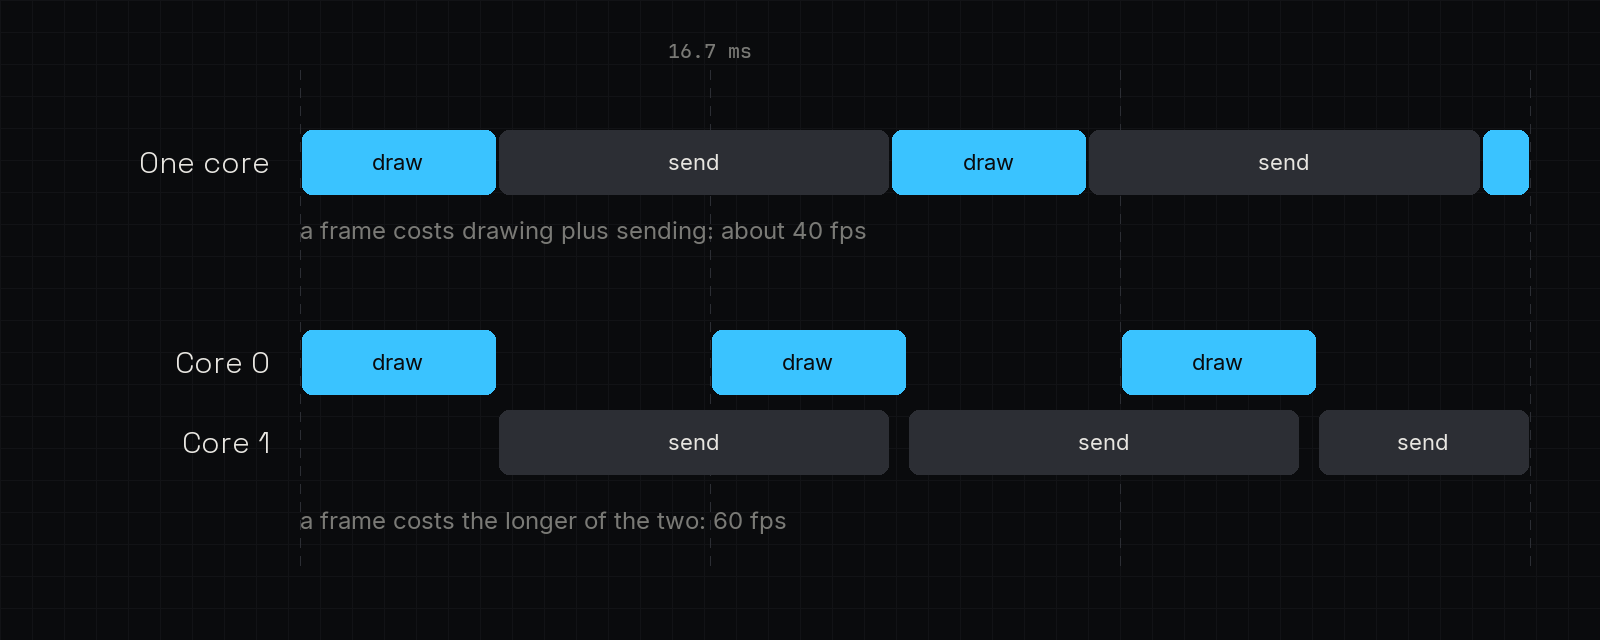
ボード側では、ディスプレイの設定 1 つでこれを有効にできます。
小さな改善と、改善にならなかったもの
- キャッシュライン。 フレームバッファは PSRAM にあり、S3 のデータキャッシュは 64 バイトのラインのほうがうまく扱えます。キャッシュを大きくするとさらに速くなりましたが、内部 RAM を消費するので、スプライトの多いシーンでメモリーが足りなくなってクラッシュしました。
- パーティクル。 各パーティクルは、エミッターの画像に描き込まれるまでに汎用のパイプラインを通っていました。このケース専用のループにしたところ、噴水 2 つで 1 フレームあたり 3.6 ms から 2.4 ms になりました。
- ダーティ矩形は効果がありませんでした。どのシーンにも変化する全画面の背景があるので、常に画面全体がダーティだったのです。ほとんど動かないシーンのために残してあります。
最終的な結果
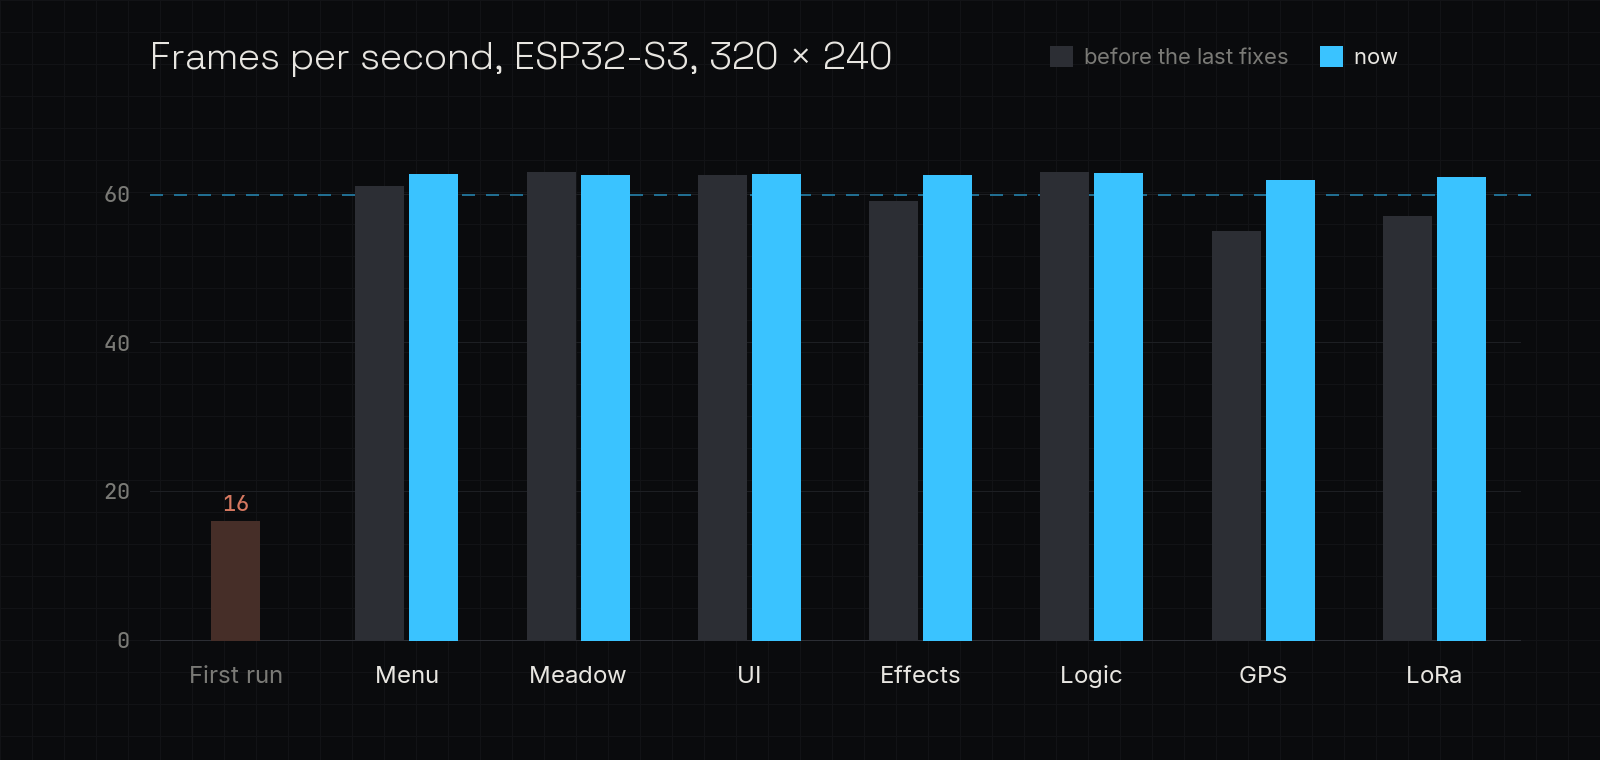
灰色のバーは、色の焼き込みとパーティクルのループを入れる前の、最後の計測です。ほかの修正はその時点ですでに入っています。テストに使ったボードは LilyGO T-Deck Plus ですが、ここにある内容はこのボードに限ったものではありません。PSRAM 付きで、LovyanGFX で駆動する SPI パネルを持つ S3 なら、同じ処理経路を通ります。