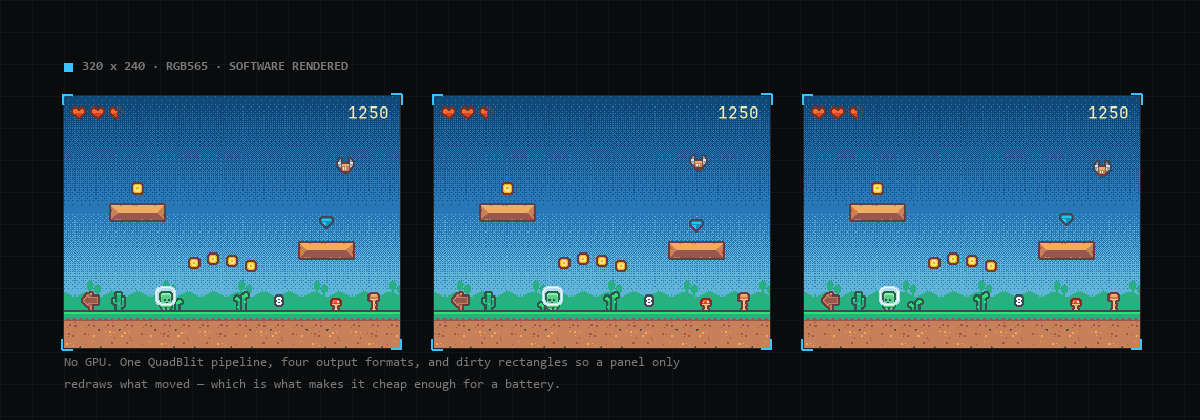
Deki 的一切都用软件绘制:没有 GPU,只有 CPU 填充帧缓冲,再由总线把它送到屏幕上。在一块带 PSRAM、接 320×240 SPI 显示屏的 ESP32-S3 上,演示最初只跑到每秒 16 帧。屏幕上的内容根本不该这么慢:一个背景、几个精灵、一些文字和少量粒子。现在每个场景都能跑到 60 到 63 帧。下面是当初挡路的那些东西。
在设备上测量
桌面上的性能分析对微控制器说明不了多少,所以第一个改动是加了一个直接询问开发板的方法。固件现在会通过它的 USB 串口响应几种请求:每秒帧数,以及平均每帧的更新、渲染和发送时间;按组件类型统计的渲染时间;还有“打开这个场景”,这样脚本就可以把每个场景挨个测一遍。(编辑器也用这些请求,见来自开发板的截图和统计。)下面的每个数字都来自这里。
编译器在为调试器构建
ESP-IDF 默认用 -Og 构建,这是为调试优化的。逐像素的 C++ 恰恰是这样构建后最慢的代码,Deki 的设备构建现在改用 -O2。
每个像素一次函数调用
像素是用 memcpy(&v, p, 2) 读取的,这是加载两个可能未对齐字节的可移植写法。在 x86 上这是一条指令。而 S3 的 Xtensa 核心不支持未对齐加载,GCC 把它编译成了对 memcpy 的调用,每个精灵的每个像素都调用一次。改为分别读取这两个字节再移位拼起来之后,blit 速度快了六倍。
不做算术的着色
着色的精灵(比如一个带颜色的 UI 面板)会走通用管线:逐像素解包、每个通道相乘、相除、混合、打包。但 RGB565 图像只有 32 种红、64 种绿和 32 种蓝,所以现在着色在每次绘制时只计算一次,做成查找表,一个不透明像素只需要三次查表。有一个测试会检查每个像素的结果都和以前完全一样。
更好的是干脆不着色。九宫格面板本来就会被拉伸成一张缓存图像,所以现在着色也一并烘焙进这张图像里,只有着色改变时才重新计算。主要由面板构成的界面从 55 fps 提升到了约 62 fps。
发送一帧要 31 ms
一帧 320×240 的画面是 150 KB。在显示屏最初使用的 40 MHz SPI 时钟下,发送它要 31 ms,在 60 fps 下几乎相当于整整两帧。这块屏幕支持 80 MHz,时间因此减半。
但这样绘制和发送仍然是一个接一个进行的,而 S3 的第二个核心闲着。现在画好的帧会放进 PSRAM 中两个缓冲区里的一个,在绘制下一帧的同时,由另一个核心把它发送出去:
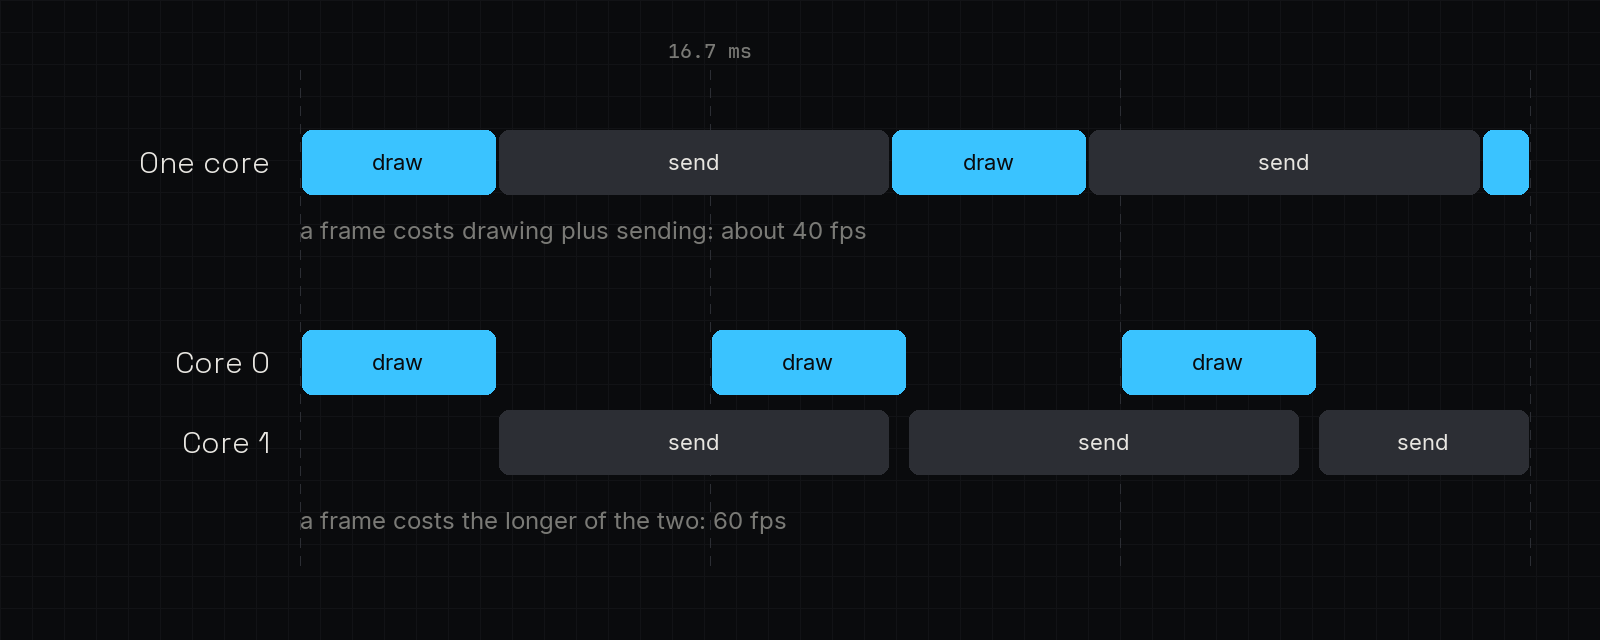
开发板只需在显示设置里开启一个选项即可启用。
小一些的收获,以及一个没成功的
- 缓存行。 帧缓冲位于 PSRAM 中,S3 的数据缓存在 64 字节缓存行下处理得更好。更大的缓存还能更快,但它要占用内部 RAM,一个精灵很多的场景因此内存耗尽并崩溃了。
- 粒子。 每个粒子在写入发射器图像时都会走一遍通用管线。为这种情况专门写一个循环后,两个喷泉的耗时从每帧 3.6 ms 降到了 2.4 ms。
- 脏矩形毫无作用:每个场景都有一个会变化的全屏背景,所以整个屏幕始终是脏的。保留它们是为了那些大部分内容静止的场景。
最终结果
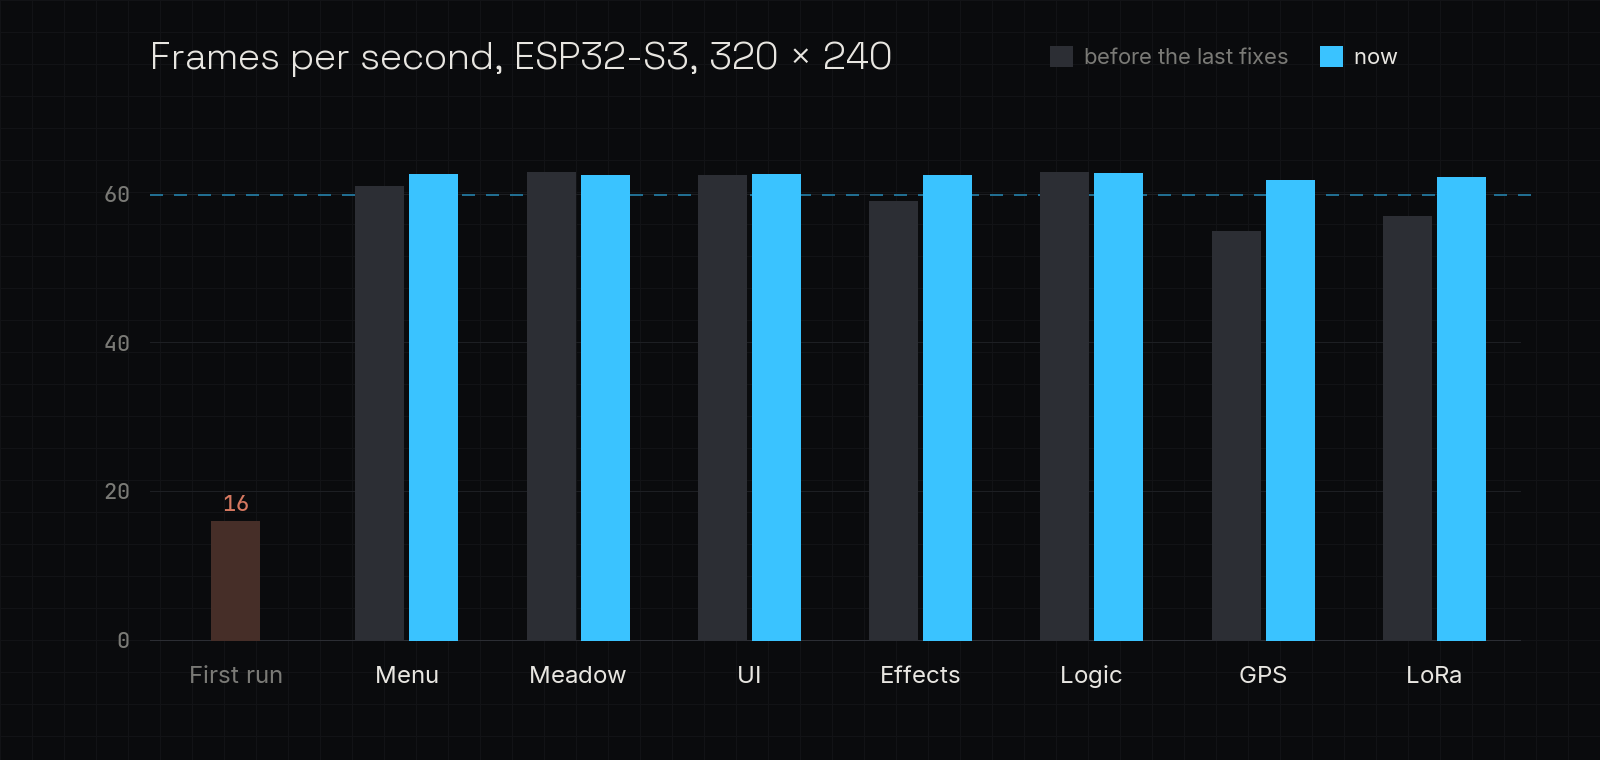
灰色条是在着色烘焙和粒子循环之前、其他修复都已加入时的最后一次测量。测试用的开发板是 LilyGO T-Deck Plus,但这里没有任何内容是它专有的:任何带 PSRAM、通过 LovyanGFX 驱动 SPI 屏幕的 S3 都会走同样的路径。